BreakingAI AI slop, conteúdo em escala e abuso: quais são as diferenças Produzir muito não significa criar material de baixa qualidade nem manipular o Google: é por isso que esses três fenômenos devem ser distinguidos
BreakingAI AI slop: o que é o novo lixo digital gerado pela IA Textos prolixos, imagens irrelevantes, vídeos de baixa qualidade: produção automatizada sem cuidado que invade a Internet
BreakingAI Digitalização destrutiva: digitalizar sacrificando o livro Dorso cortado, encadernação removida e páginas adquiridas uma a uma: um método rápido e eficiente, mas totalmente irreversível
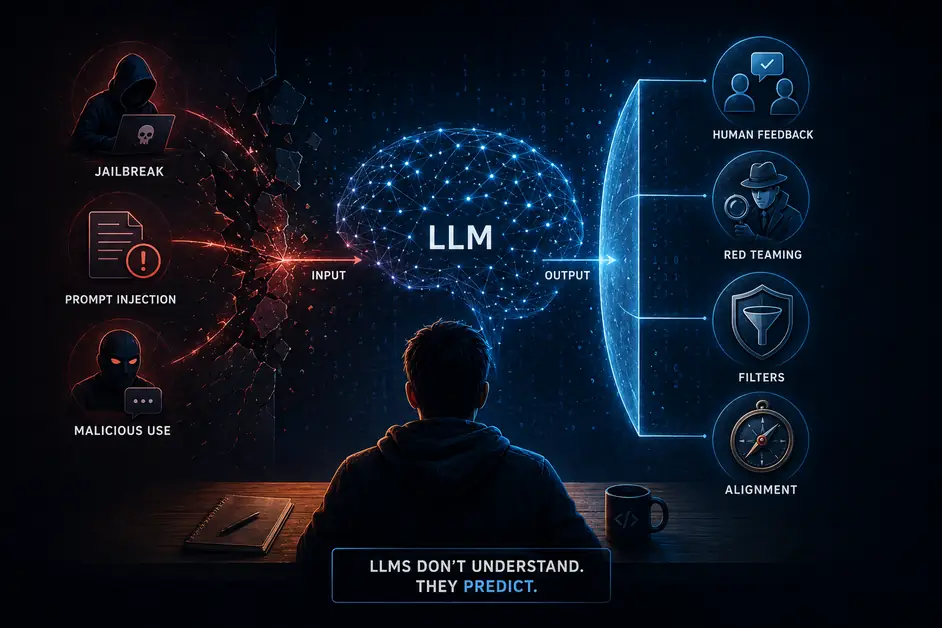
BreakingAI Bug, jailbreak e injeção de prompt: o que eles realmente têm em comum Bug, jailbreak, injeção de prompt. Três problemas diferentes, uma raiz comum: um LLM não segue regras escritas no código — aprendeu comportamentos a partir de bilhões de exemplos. Por isso, corrigi-lo é muito mais complexo do que aplicar um simples patch.
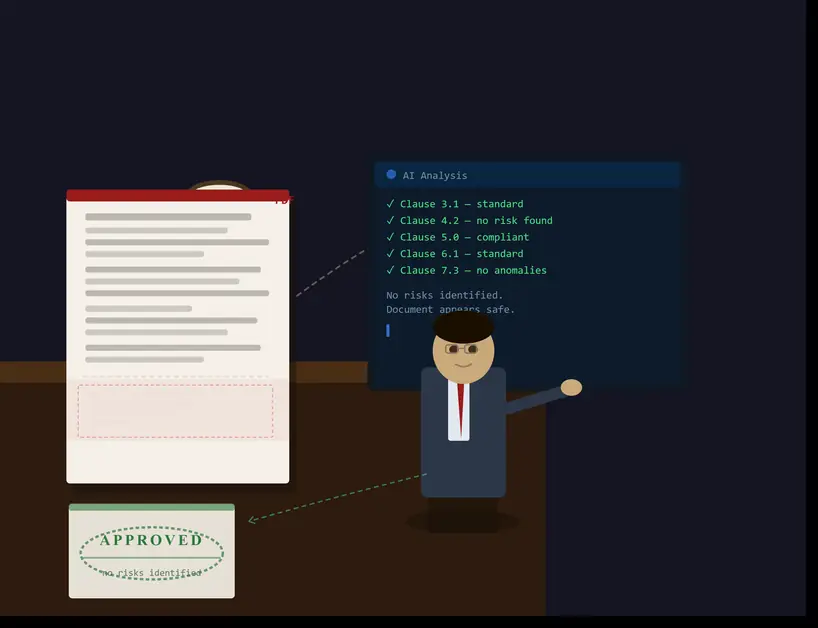
BreakingAI Injeção de Prompt: o truque usado para manipular um LLM Entre as técnicas usadas para manipular o comportamento de um LLM, a injeção de prompt é uma das mais difíceis de identificar. Basta esconder as instruções no lugar certo — e esperar que ele as execute por conta própria.
BreakingAI Como convencer um LLM a ignorar suas regras Um LLM não erra apenas por culpa sua. Às vezes, ele erra porque alguém o faz errar intencionalmente. O jailbreak não é um ataque cibernético como o entendemos normalmente: ninguém entra em um servidor, ninguém força uma senha, ninguém quebra uma fechadura digital.
BreakingAI Por que um LLM erra mesmo quando parece confiante? Porque não sabe, prevê. Erra porque não tem um motor da verdade dentro de si. Tem apenas um motor estatístico da linguagem. Quando responde, não está afirmando o que é verdade: está completando uma frase da maneira mais provável com base em bilhões de exemplos.