المسح المدمر: رقمنة على حساب الكتاب
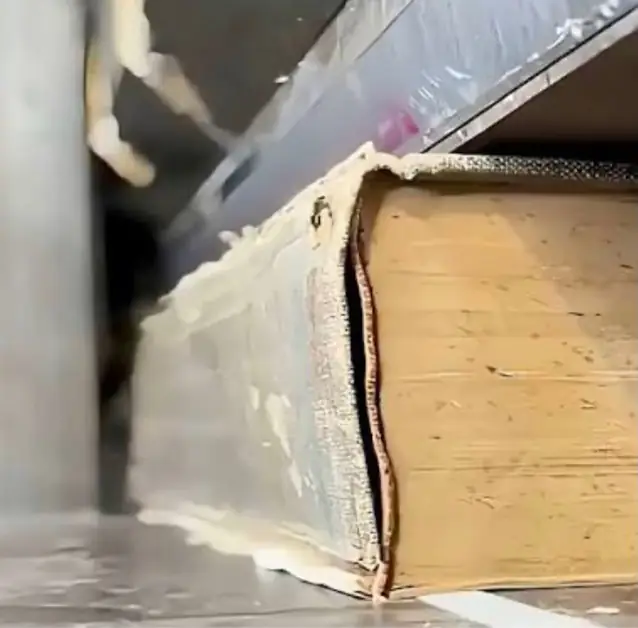
ظهر مقطوع، تجليد مزال وصفحات تم الحصول عليها واحدة تلو الأخرى: طريقة سريعة وفعالة، لكنها غير قابلة للعكس تمامًا
قبل أسابيع، وجدت Anthropic، الشركة المطوّرة لـClaude، نفسها وسط معركة قضائية. وُجّهت إليها تهمة استخدام آلاف الكتب المقرصنة لتدريب نماذجها. وانتهت القضية بتسوية بلغت 1.5 مليار دولار. لكنها أثارت سؤالًا أهم: من أين تحصل الشركات على النصوص؟ فهي تحتاج كميات هائلة منها لتدريب الذكاء الاصطناعي.
بحسب ما ظهر في القضية، لا يجوز لشركات الذكاء الاصطناعي الحصول على نسخ مقرصنة من الكتب. لكن يمكنها شراء الكتب الورقية بشكل قانوني. ثم تحوّلها إلى نسخ رقمية وتستخدم نصوصها لتدريب نماذجها. والفرق هنا مهم: الكتاب الأصلي اشتُري بشكل قانوني. والنسخة الرقمية تحلّ محلّ النسخة الورقية، ولا تُضاف إليها.
هنا يأتي دور المسح الضوئي الإتلافي. يُفكك الكتاب، ويُقطع ظهره، وتُزال تجليدته. ثم تُمسح صفحاته واحدةً تلو الأخرى. هكذا يمكن إدخالها بسرعة في ماسحات ضوئية آلية. وتتحول إلى ملفات رقمية يمكن استخراج النصوص منها لاحقًا. الطريقة فعالة، لكنها لا تترك مجالًا للتراجع. فالكتاب الأصلي يصبح غير قابل للاستخدام بعدها.
وهذا يجعل الكتب مصدرًا ثمينًا لمطوري نماذج الذكاء الاصطناعي. فهي لا تضم كميات هائلة من النصوص فحسب. بل تضم أيضًا محتوى نُشر قبل الانتشار الواسع للذكاء الاصطناعي التوليدي. لذلك قد تكون الكتب المنشورة قبل 2022 أكثر قيمة. وقتها، لم تكن أدوات مثل ChatGPT جزءًا من حياة الملايين اليومية.
أما المحتوى الأحدث، فتظهر معه مشكلة جديدة. تُسمى "AI slop"، أي تزايد النصوص التي ينتجها الذكاء الاصطناعي. بعضها يُنتج بالكامل، وبعضها الآخر جزئيًا. وإذا استُخدمت لتدريب نماذج جديدة، يزداد خطر تعلّم الذكاء الاصطناعي من نصوص أنتجها الذكاء الاصطناعي نفسه. بدلًا من التعلّم من نصوص كتبها البشر أصلًا. ومن هذه الزاوية، قد تصبح مكتبة ورقية قديمة حديثةً بشكل مفاجئ. فهي مخزون بيانات يسبق طفرة الذكاء الاصطناعي التوليدي.