Digitalização destrutiva: digitalizar sacrificando o livro
Dorso cortado, encadernação removida e páginas adquiridas uma a uma: um método rápido e eficiente, mas totalmente irreversível
Há algumas semanas, a Anthropic, empresa que desenvolve o Claude, enfrentou um processo. A acusação? Usar milhares de livros pirateados para treinar seus modelos. O caso terminou num acordo de 1,5 bilhão de dólares. Mas deixou uma pergunta ainda mais interessante. Onde as empresas conseguem tantos textos para treinar IA?
O caso deixou uma coisa clara. Empresas de IA não podem obter cópias piratas ilegalmente. Mas podem comprar livros impressos, digitalizá-los e usar os textos. Assim, treinam seus modelos com material adquirido legalmente. A diferença importa: o livro original foi comprado legalmente. E a versão digital substitui a física, sem criar outra cópia.
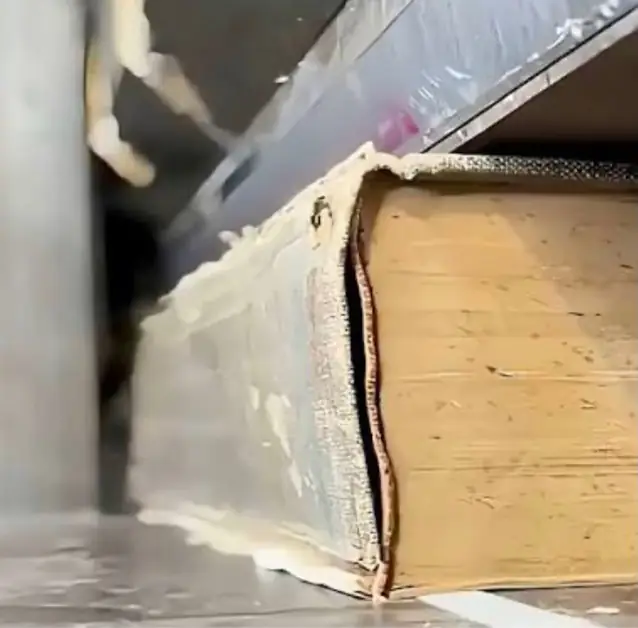
É aqui que entra o destructive scanning. O livro é desmontado: cortam a lombada e retiram a encadernação. Depois, digitalizam as páginas uma a uma. Assim, podem passar rapidamente por scanners automáticos. Viram ficheiros digitais, onde depois é possível reconhecer o texto. É um processo eficiente, mas irreversível. No fim, o livro original já não pode ser usado.
Por isso, os livros são especialmente valiosos para quem desenvolve modelos de IA. Não é só pela enorme quantidade de texto. É sobretudo porque foram publicados antes da popularização da IA generativa. Os livros anteriores a 2022 podem valer ainda mais. Nessa altura, ferramentas como o ChatGPT ainda não faziam parte do quotidiano de milhões de pessoas.
Com os conteúdos mais recentes, há um problema novo: o chamado "AI slop". São textos produzidos, total ou parcialmente, por sistemas de IA. E há cada vez mais. Se servirem para treinar novos modelos, o risco aumenta. A IA pode acabar por aprender com textos gerados por IA, em vez de textos escritos originalmente por pessoas. Visto assim, uma velha biblioteca pode ser surpreendentemente moderna. Guarda textos anteriores à explosão da IA generativa.